 Café virtuel
Sept propositions pour explorer l’IA, mettre des idées à l’épreuve et examiner les résultats.
01Exercice de formation · Données synthétiquesQue peut-on apprendre de 300 enregistrements synthétiques ?Ma première pratique d’analyse avec l’IA et Google Colab : calculer, interpréter et vérifier les résultats.Ouvrir la pratique
Données synthétiques
Contexte
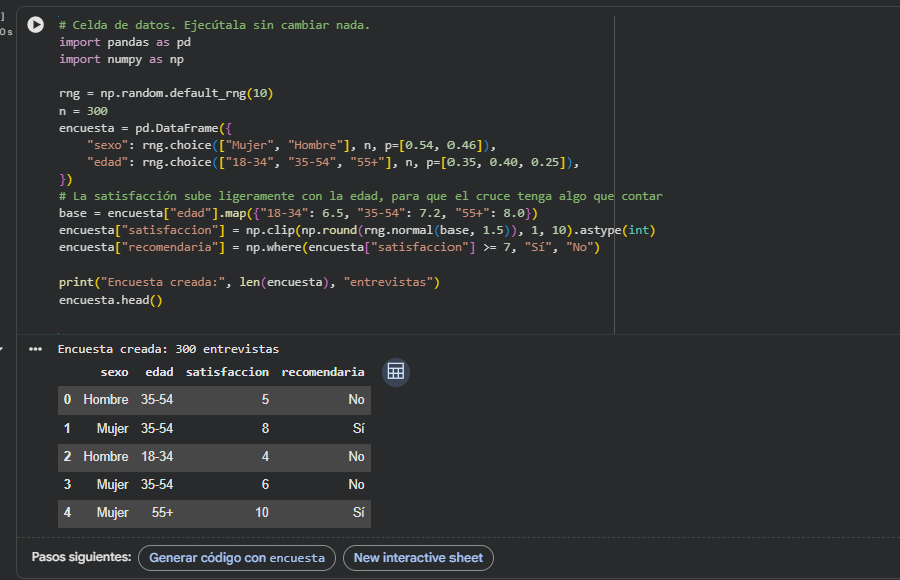
Pratique de formation avec 300 observations synthétiques, générées par le code fourni dans le cours : Curso Práctico de Inmersión en la IA para Investigadores de Mercados, 10.ª edición, de Insights + Analytics España. Cette fiche documente les exercices 3 et 4.
Ce que je voulais examiner
Résumer un tableau de 300 observations : répartition par sexe et satisfaction moyenne par tranche d’âge.
Méthode
- Définir le calcul et comprendre les concepts
- Générer du code avec l’aide de l’IA
- L’exécuter dans Colab
- Examiner les résultats
- Les représenter graphiquement
Éléments de preuve
Résultats
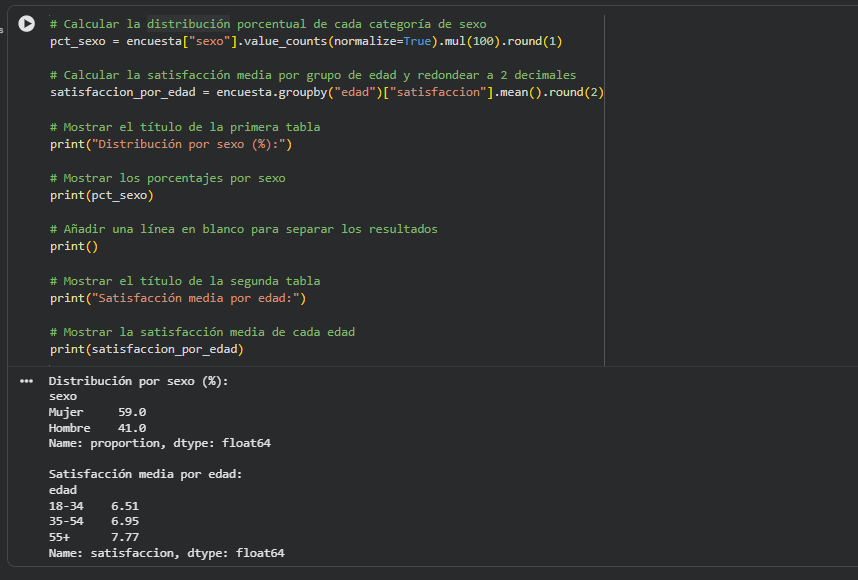
Répartition par sexe
Pourcentage du total des 300 observations synthétiques.
| Groupe | Pourcentage |
|---|---|
| Femmes | 59 % |
| Hommes | 41 % |
Satisfaction moyenne par âge
Note moyenne sur 10. Elle ne représente pas un pourcentage de personnes.
| Tranche d’âge | Moyenne (sur 10) |
|---|---|
| 18–34 | 6,51 |
| 35–54 | 6,95 |
| 55+ | 7,77 |
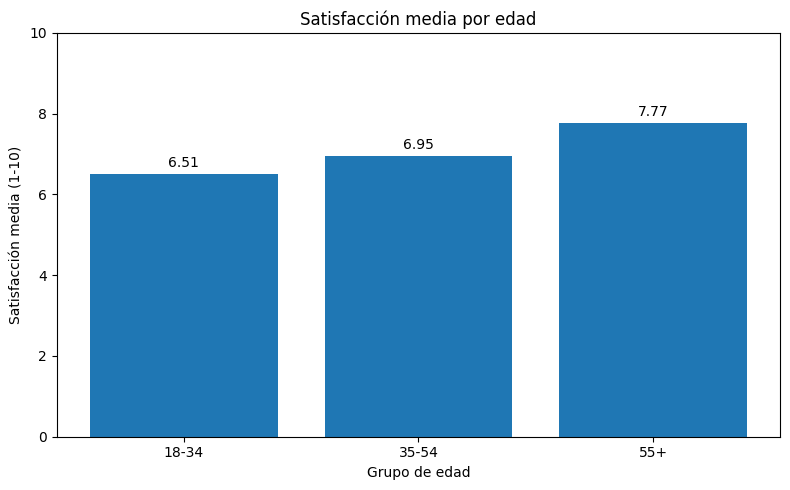
Exercice de formation avec 300 enregistrements synthétiques. La tendance d’une satisfaction plus élevée avec l’âge a été intégrée lors de la génération des données. Ce n’est pas un résultat concernant de vrais clients.
Interprétation et limites
Lecture des résultats
J’ai distingué les indicateurs selon ce qu’ils décrivent : la répartition en pourcentage montre la composition des enregistrements, tandis que les moyennes résument les notes de chaque groupe. Le graphique permet de les comparer sur la même échelle.
02 Exercice interactif · Cas fictifPrompt ControlComment une réponse change quand la manière de la demander change. Ouvrir la pratique
Ce cas de Prompt Control utilise une situation fictive et ne contient aucune donnée réelle de clientèle ou d’entreprise.
Ce que je veux observer
Je fais la même demande cinq fois, en ajoutant à chaque fois une couche de plus, et je compare comment la réponse évolue. L’idée de fond : bien travailler avec l’IA, ce n’est pas poser une question, c’est bien préparer la demande.
Comment je le teste
- 1 · Juste la question
- 2 · + pour qui et pour quoi
- 3 · + ton, format et limites
- 4 · + un exemple de ce que j’attends
- 5 · + « vérifie avant de répondre »
- Je compare les 5 réponses
Traduction française des échanges originaux en espagnol.
Exemple pas à pas · ChatGPT, chaque version dans une nouvelle conversation
Cas : l’avis de Marta, cliente fidèle, dont la commande est arrivée avec cinq jours de retard sans que personne ne la prévienne.
Version 1
Ce que j’ai demandé
« Réponds à cet avis. »
Ce qu’elle a répondu
« Bonjour Marta, nous sommes vraiment désolés du retard et, surtout, de ne pas t’avoir informée que ta commande arriverait plus tard que prévu. Nous comprenons ta déception, d’autant plus après toutes ces années de confiance. Merci de nous l’avoir fait savoir. Nous examinerons ce qui s’est passé pour éviter que cela se reproduise et améliorer notre communication en cas de problème de livraison. Nous espérons regagner ta confiance lors de ta prochaine expérience avec nous. »
Version 2
Ce que j’ai ajouté
Pour qui et pour quoi : « C’est Marta, cliente fidèle d’une boutique en ligne. L’objectif est qu’elle se sente écoutée et nous refasse confiance. »
Ce qu’elle a répondu
« Bonjour Marta, nous sommes vraiment désolés du retard et, surtout, de ne pas t’avoir prévenue à temps. Nous comprenons parfaitement ta déception, d’autant plus après toutes ces années de confiance. Merci de nous en avoir parlé. Nous allons examiner ce qui s’est passé pour éviter que cela se reproduise et améliorer la communication en cas de problème avec une commande. Nous espérons pouvoir regagner ta confiance lors de ton prochain achat. »
Version 3
Ce que j’ai ajouté
Ton, format et limites : « Ton chaleureux et sincère, sans excuses ni phrases toutes faites. Quatre phrases maximum. Ne propose pas de réduction. »
Ce qu’elle a répondu
« Marta, je suis désolé que ta commande soit arrivée avec cinq jours de retard et que nous ne t’ayons pas prévenue. Je comprends ta déception, surtout après toutes ces années à acheter chez nous. Nous allons examiner ce qui n’a pas fonctionné dans le suivi et l’annonce du retard. Nous voulons regagner ta confiance grâce à une meilleure expérience. »
Version 4
Ce que j’ai ajouté
Un exemple du style recherché, tiré d’un autre cas : « Javier, tu as raison : le produit ne correspondait pas à ce que nous montrions sur la photo. Nous avons déjà corrigé cela sur le site pour que cela n’arrive à personne d’autre. Merci de nous l’avoir signalé avec autant de détails. »
Ce qu’elle a répondu
« Marta, tu as raison : en plus du retard, nous aurions dû te prévenir que ta commande n’arriverait pas à temps. Nous savons que tu nous fais confiance depuis des années et nous comprenons que cette fois, nous t’ayons déçue. Merci de nous l’avoir dit ; nous examinerons ce qui n’a pas fonctionné dans la communication pour éviter que cela se reproduise. »
Version 5
Ce que j’ai ajouté
Une relecture avant de répondre : « Relis ton brouillon : qu’il ne promette rien que nous ne puissions tenir, qu’il ne sonne pas comme un modèle et qu’il réponde à ce qui l’a le plus gênée. »
Ce qu’elle a répondu
« Marta, tu as raison : le plus gênant, ce n’était pas seulement les cinq jours de retard, mais que personne ne t’ait prévenue. Après toutes ces années à acheter chez nous, nous comprenons d’autant plus ta déception. Merci de l’avoir signalé aussi clairement ; nous examinerons la manière dont nous communiquons ce type d’incidents pour éviter que cela se reproduise. »
Chaque version ajoute une couche à la précédente.
Le rôle humain
Compare les réponses et évalue celle qui correspond le mieux au besoin, et pourquoi.
Apprentissages
Le contexte seul a peu changé la réponse. Préciser le ton et la longueur, puis donner un exemple, l’a améliorée. La relecture finale s’est concentrée sur ce qui avait le plus contrarié Marta : l’absence d’avertissement. Il restait une dernière retouche humaine.
03 Proposition conceptuelleResearch FlowQuelle partie d’une recherche peut être automatisée sans automatiser l’interprétation. Ouvrir la pratique
Ce que je veux observer
Jusqu’où va la machine pour mettre de l’ordre, et où commence le travail de compréhension. Un schéma est un indice, pas forcément l’explication.
Comment je le teste
- Commentaires clients
- Classification automatique
- Regroupement thématique
- Détection de schémas
- Hypothèses
- Vérification humaine
Le rôle humain
Examine les hypothèses, les confronte au contexte et décide ce qui mérite d’être approfondi.
Apprentissages
Organiser l’information et la comprendre sont deux travaux différents. Le contexte demande toujours une interprétation.
04 Proposition conceptuelleHuman in the loop (HITL)Où automatiser et à quel moment une personne doit intervenir. Ouvrir la pratique
Ce que je veux observer
Quelles tâches peuvent s’enchaîner seules et à quel moment une vérification humaine évite des erreurs qui coûtent cher ensuite.
Comment je le teste
- Entrée
- L’IA traite
- Validation humaine
- Continuer · Corriger · Arrêter
Le rôle humain
Décide au point de validation : le résultat continue, est corrigé ou s’arrête.
Apprentissages
Un flux a besoin de points de contrôle où une personne peut le corriger ou l’arrêter.
05 Proposition conceptuelleAI Quality CheckComment éviter de valider une réponse simplement parce qu’elle semble véridique. Ouvrir la pratique
Ce que je veux observer
Qu’une réponse bien écrite n’est pas forcément une réponse fiable, et quels contrôles aident à les distinguer.
Comment je le teste
- L’IA génère une réponse
- Deuxième niveau de vérification : sources, contradictions, erreurs et biais
- Niveau de confiance
- Une personne décide si elle tient la route
Le rôle humain
Lit la vérification et décide si la réponse convient, doit être modifiée ou est écartée.
Apprentissages
Il faut regarder le contenu et les sources, au-delà de la façon dont la réponse est rédigée.
06 Proposition conceptuelleAI vs AICe qui se passe quand une IA confronte ou questionne la réponse d’une autre. Ouvrir la pratique
Ce que je veux observer
Si le désaccord entre agents aide à voir les angles morts… ou ajoute seulement du bruit.
Comment je le teste
- Un agent propose une interprétation
- Un autre agent la remet en question : cherche les failles et d’autres explications
- Confrontation des arguments
- La décision finale est humaine
Le rôle humain
Écoute les deux agents, confronte leurs arguments et prend la décision finale.
Apprentissages
Deux réponses différentes ouvrent des questions. Leur divergence ne prouve pas à elle seule laquelle est correcte.
07Exercice interactif · Capture d’écranModel ChoiceLire les benchmarks avec discernementQuel modèle choisir selon la tâche ?Ouvrir la pratique
Lire une capture de benchmarks, distinguer les mesures et vérifier ce que nous pouvons en conclure.
Choisir selon la tâche
Une tâche simple peut demander de la rapidité. Une tâche répétitive peut rendre le coût plus important. Et une tâche complexe peut justifier de sacrifier les deux.
Capture d’octobre 2026. Elle ne se met pas à jour en temps réel.
Speed mesure les tokens de sortie par seconde. Cost per Task est le coût moyen pondéré du benchmark, pas le prix garanti de votre propre tâche.
Source : Artificial Analysis ↗
Quatre questions pour explorer la capture. Vous pouvez changer de réponse.
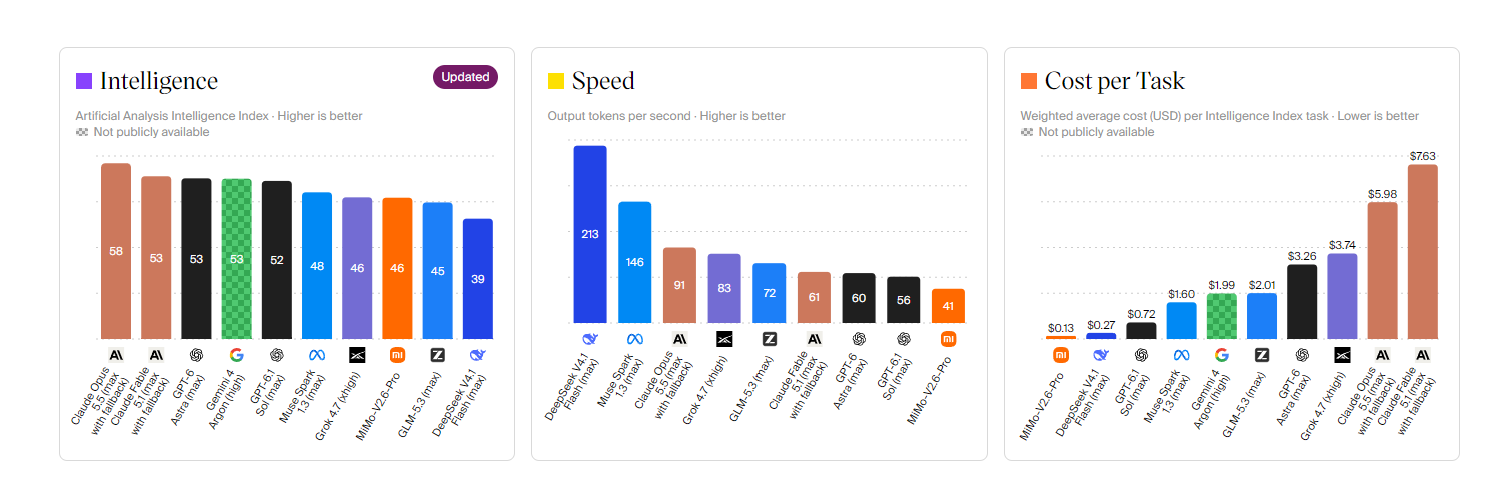
Selon la capture, lequel génère le plus de tokens par seconde ?
Lequel a le Cost per Task le plus bas dans cette capture ?
Parmi ces trois options, laquelle a le score Intelligence le plus élevé ?
Ces graphiques permettent-ils de choisir le plus efficace pour toute tâche ?
Plus rapide, moins cher et plus adapté sont des questions différentes. La décision commence par définir ce que nous voulons obtenir.